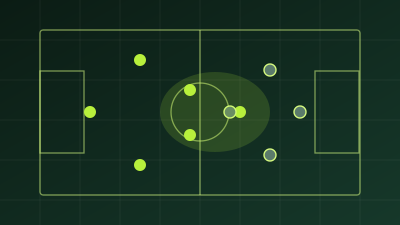
首发名单上写着4-3-3,转播画面左下角也写着4-3-3。但如果你在第32分钟随手暂停,把双方站位截下来,会看到右边后卫已经站到了对方半场的边线上,后腰落到两名中卫之间,剩下的中场和边锋挤在前场。你说这还是4-3-3吗?名单上的数字是一个赛前的意图,比赛里的球队每几秒钟都在变形。AI要识别阵型,得先接受一件事:阵型不是贴在球队身上的固定标签,而是某个阶段里球员位置的大致形状。
名单上的阵型,只回答"打算怎么站"
阵型的数字写法(4-4-2、4-3-3、3-5-2)按由后往前的顺序数每条线上的人数,守门员不计入。这种写法方便沟通,却隐去了太多东西:线与线之间隔多远,边路球员是靠前还是靠后,中场是平行站位还是三角形。更关键的是,它默认了一个"平均状态",而比赛里球队至少有几种明显不同的状态:本方持球、对方持球、由攻转守、由守转攻,还有开球、任意球和角球这类死球阶段。同一支球队在这些阶段的形状完全可能不一样。
所以在追踪数据的语境下,"识别阵型"更准确的说法是"描述某一阶段的球队形状"。识别的结果不该是一个唯一正确的数字,而应该是一个带着阶段、时间范围和不确定性的描述,比如"本方持球的第10到第14分钟,形状接近3-2-5"。
从坐标到形状:先切阶段,再取平均
追踪数据给出的是每名球员每一帧的x、y坐标。直接把整场比赛的位置取平均,得到的是一个失真的形状:进攻时的前压和防守时的回收会互相抵消,边后卫的平均位置会落在中场附近,这个位置在比赛里几乎从没出现过。所以第一步必须是切阶段。常见的做法是根据球权归属、球的位置、整体前压程度,把时间轴划分成若干段:有球(组织、推进、进攻三区)、无球(高位、中位、低位防守)以及转换的短暂时刻。转换阶段和死球阶段的形状不稳定,通常不参与阵型识别,或者被单独处理。
切好阶段之后,再对每一段里的球员位置做处理。一个常用的方法是:以球队整体的质心为参照,把位置平移到相对坐标,避免球队整体前压带来的偏差;然后取这一段时间窗口内每名球员的平均位置或中位位置,得到十名场上球员(不含门将)的形状。如果想看形状的"稳定程度",还可以同时计算每名球员位置的波动范围。有些球队站位纪律严明,平均位置附近的活动范围很小;有些球队球员大量互换位置,平均位置就更像一个模糊的云团。
22个点怎么对上"左后卫""右边锋"
拿到十个平均位置以后,下一个问题是给它们分配角色。最朴素的做法是按x坐标分线:把十名球员按离本方球门的距离排序,用聚类的办法把他们分成三到四条线,再数每条线上的人数,得到一个"4-3-3"或"4-4-2"这样的数字。这个方法简单,但对"位置模糊"的球员很不友好:一名站在中场线附近的边路球员,可能被归到后卫线,也可能被归到中场线,一个人的归属变化就让整个数字改变。
更细致的做法,是准备一组"角色模板",比如4-3-3的标准形状里,有左后卫、左中卫、右中卫、右后卫、后腰、两名中场、左边锋、中锋、右边锋,然后把实际球员的位置和模板位置做匹配。这个匹配问题的直觉是:给每个"球员—角色"配对算一个代价(球员平均位置离角色模板位置有多远),要求每名球员恰好占一个角色、每个角色恰好由一名球员担任,找出总代价最小的配对方案。这在计算机里是一个经典的指派问题,匈牙利算法能高效地求解。对每一种候选阵型(4-4-2、4-3-3、3-5-2等)都做一次匹配,总代价最小的那个模板,就是"最像"的阵型。
除了"模板匹配",还有一种反过来的思路:不预设阵型,让数据自己说话。把每一帧(或每一小段)球队的形状表示成一组相对坐标,再对整场比赛里的这些形状做聚类,看看球队一共出现了几种典型的站位。这种做法的好处是,它不会被"名单上写着什么"限制,能发现教练没有明说的变形;缺点是聚类结果往往是一组没有名字的形状,需要人去命名和解释,而且聚类的个数、距离的定义,都会影响最后看到的"几种阵型"。实际应用里,常见的做法是两者结合:先用聚类找出球队常用的几种形状,再用模板匹配给它们贴上大家熟悉的名字。
这里要注意的是:匹配得分最低不等于"这就是它的阵型"。如果最好和次好模板的代价差不多,说明球队的形状本来就介于两者之间,这个时候系统应该报告"不确定",或者并列列出两个候选,而不是强行只给一个数字。
一个模拟例子:边后卫上提,4-3-3变成了3+2
看一个模拟场景。某支球队首发名单是4-3-3。在本方持球的一段时间里,两名边后卫分别前压到了对方半场的边线区域,后腰下沉到两名中卫之间接应出球。这段时间里的平均位置(示例数据)大致如下:
| 阶段 | 后线人数 | 中场人数 | 前线人数 | 最接近的描述 |
|---|---|---|---|---|
| 名单阵型 | 4 | 3 | 3 | 4-3-3 |
| 本方持球,推进阶段 | 3(两名中卫加下沉后腰) | 2(两名中场) | 5(两名上提边后卫、两名边锋、中锋) | 3-2-5 |
| 对方持球,中位防守 | 4 | 3 | 3 | 接近4-1-4-1或4-3-3 |
这张表想说明的是,在同一场比赛里,同一支球队至少有两个可以被合理描述的阵型。进攻阶段变成三名后卫加两名中场,教练称之为"3+2"出球结构;防守阶段回到四后卫。这种变化并不是球队在违背战术,恰恰相反,它往往就是战术的一部分:让边后卫上提以增加边路的进攻宽度,用后腰的回撤保证后场出球时有三名球员可以形成三角。
如果AI只在整场比赛里给出一个"4-3-3"的标签,教练完全看不到这个变化;如果它按阶段切分再匹配,看到的是"本方持球阶段更接近3-2-5,这个形状占了持球时间的大部分",这个信息才与战术复盘直接相关。它也带来了更深一层的问题:既然阵型随阶段变化,那么解读球场空间时,必须先知道球队此刻是什么形状。《足球AI已经不满足于画热力图:od体育开始分析阵型、跑位和球场空间到底是谁创造的》里谈到的空间分析,就是以阵型为底稿去理解谁占据、谁创造了空间。
AI认错阵型,通常错在这几个地方
阵型识别在实验室里看起来干净利落,到了真实追踪数据上,会遇到不少麻烦。
把两种状态平均成第三种
如果时间窗口取得太长,一支在进攻时是3-2-5、防守时是4-4-2的球队,会被平均成一个"4-3-3",而这个形状在比赛里几乎没出现过。窗口取得太短,又会被短暂的移动噪声左右:一名球员只是绕开对手多跑了几米,整个阵型的数字就改变了。窗口的长度需要和"阶段"的划分配合,没有一个通用的最佳值。
角色互换被当成阵型改变
现代球队里,边锋与中锋、两名中场之间经常互相换位。如果角色匹配只看位置,就会把"左边锋和中锋互换了位置"当成阵型变化,其实这是同一个阵型下的球员轮转。要区分这两种情况,需要看整体形状有没有改变,而不只是个别球员的位置。
红牌、伤病与球队分类错误
场上人数发生变化(红牌、换人)后,十名外场球员的模板匹配会失效,需要动态调整。基于视频的追踪里,球衣颜色相近、门将与球员颜色接近、裁判被误认成球员,也会给匹配带来干扰。这类错误在数据里往往安静地出现,如果没有对人数、门将身份做检查,结果看起来依然"合理"。
形状相似,任务不同
两支球队的平均位置可以几乎相同,但球员的职责完全不一样:一个边后卫留在原地是为了保护身后空间,另一个则是刚好被压回去。阵型只描述了形状,而没有描述意图。对这一点,AI既无法从位置数据里直接看出,也不应该假装能看出。
还有一类容易被忽视的问题来自数据本身。基于转播视频的追踪,镜头往往只覆盖场上的一部分区域,画面之外的球员位置需要靠前后帧推断,甚至用队形的常识来补全。如果AI再拿这些补出来的位置去做阵型匹配,就等于用一个推断的结果去验证另一个推断,误差会被叠加。对这种数据,稳妥的做法是给每一帧标注"可见球员数",可见的球员太少时,直接跳过这一帧,而不是勉强给出一个形状。
教练怎么用:把阵型当作"对话的起点"
比较务实的用法,是让阵型识别帮助教练快速回答几个具体问题:本方持球阶段主要用什么结构?对方压上来的时候,我们的形状是不是被拉散了?换人之后,形状与赛前预设的差多少?这些问题过去需要教练助手一场比赛反复回看才能整理,现在可以先由系统给出按阶段划分的形状与占比,教练再去回看视频确认。
阵型识别还能和压迫分析结合。对手在不同形状下的高位逼抢,会留下不同的出口,比如对方用4-4-2逼抢时,两名前锋之间的空当往往是我方后腰接应的位置。这类"形状对形状"的分析,在《高位逼抢到底有没有效果?od体育AI如何计算压迫强度和传球出口》里有具体的展开,可以配合着读。
在od体育的设计思路里,阵型的输出是分阶段、带置信度的:如果最好和次好的候选模板代价接近,就直接标注"介于两者之间";如果追踪数据里出现人数变化或身份切换过多,就提示"该段落不做阵型判断"。阵型标签只是描述球队在某一段时间的样子,什么时候变、为什么变,仍然需要教练根据比赛的进程和自己的战术意图来判断。
所以回到最初的问题:433真的一直是433吗?在大多数比赛里不是。它是赛前的一份意图,是一场比赛里的若干个阶段之一,也是AI在给出"这一段更像什么"时,一个需要被谨慎对待的近似。