体育视频AI最容易被误读的进步,是解说变得像样了
把一段足球比赛视频交给多模态大模型,让它写一段解说,现在的结果往往相当流畅:谁在左路拿球,谁回撤接应,进攻如何一点点推进到禁区。读起来像样,不等于看懂了。教练关心的问题从来不是“第几分钟发生了一次射门”,而是“这次进攻为什么成立”:是边锋拉开了宽度,还是对方中场在转身那一瞬间失去了保护?前一类问题是事件识别,后一类问题是战术推理,这两者之间的距离,比画面上看到的要远得多。
这篇文章是od体育对这一趋势的观察:行业和学界正在把注意力从“认出发生了什么”挪向“解释为什么发生”。这个转向的方向是对的,但走起来有几个绕不过去的坎:证据从哪里来,时间跨度有多长,说出来的解释如何验证。下面按这几个问题逐一拆开,最后说明od体育在自己的产品里怎样取舍。
从“发生了什么”到“为什么发生”,中间隔着三级台阶
为了说清这段距离,不妨把体育视频理解分成三个层级。这个划分是一种便于讨论的思路,并不是行业标准,但它能帮助我们判断一个系统到底走到了哪一步。
| 层级 | 回答的问题 | 典型输出 | 需要的证据 |
|---|---|---|---|
| 事件层 | 发生了什么 | 传球、射门、抢断、角球的时间点 | 单个镜头或短片段里的画面动作 |
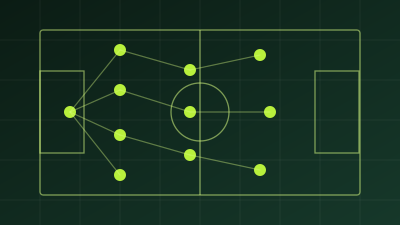
| 关系层 | 谁和谁、在哪里 | 球员位置关系、阵型形状、传球线路是否被封 | 多名球员的位置、追踪ID、场地坐标 |
| 因果层 | 为什么会这样 | “这次进攻成立,是因为拉边牵制了防线” | 跨越几十秒的连续证据,加上对手的反应 |
这三级台阶的难度并不是线性增长的。事件层已经有了多年积累的开放基准和成熟方法;关系层依赖球员追踪和场地坐标,精度受视角、遮挡和镜头切换的影响;到了因果层,问题的性质变了:它要求模型不仅“看见”,还要在一段很长的画面里找出“哪些事真的推动了结果”。这里的每一个结论,都可能被另一种同样自洽的解释所替代。
SoccerNet的任务清单在变长,说明了什么
观察这个趋势,最好的窗口之一是SoccerNet。这是自2018年起面向足球视频理解的开放基准,2026年举办的是第六届挑战赛。早期任务集中在广播视频的动作定位(action spotting),也就是从整场比赛的视频里找出进球、犯规、换人等事件的时间点。而在最近几届里,任务清单逐渐扩展到场地理解、球员理解和比赛理解,并且引入了视觉问答(VQA):向系统提一个关于比赛的问题,让它给出答案。
这个变化的含义值得多想一步。视觉问答里的很多问题,并不能靠看一帧画面回答:它可能同时要求画面感知(谁在画面里、球在哪里)、时间定位(这件事发生在哪几秒)、比赛上下文(当前比分、比赛阶段)和领域知识(越位规则、常见的防守站位)。也就是说,基准设计者已经承认,单纯的事件识别不足以衡量“看懂比赛”,需要把感知、时序和知识合在一起考。从这个角度看,“战术推理”并不是营销口号,而是研究任务本身向前走出的自然一步。
解说写得流畅,证据在哪里
另一条平行的进展线是多模态大语言模型。它们在足球解说生成、视频字幕、图文检索这类任务上的进步很明显,读起来通顺、有节奏,像模像样。然而研究者反复指出的一个问题是:缺少精确的“视觉证据标注”。也就是说,我们很难验证模型的某句判断,是不是真的基于画面里的某个具体证据,还是基于它见过的大量解说文字里的套路。
举一个模拟的例子。假设一段模拟视频里,红队右后卫前插,模型的解说写道:“右后卫的前插拉开了对方防线的宽度,为中路创造了空间。”这句话读起来合情合理,可是要核对它,就需要回答一连串很具体的问题:这名后卫在这几秒里真的越过了中线吗?对方左边锋是否被他带着回撤?中路的空间在哪一帧出现?如果模型只是根据“右后卫前插”这一事件,套用了“前插会拉开宽度”这个常见解释,那么这句话即使碰巧是对的,也不能算“看懂了”。没有证据标注的时候,正确的解释和顺口的套话,看上去没有区别。
长视频:一次进攻的因果链有多长
战术推理的第二个难点是时间跨度。一次成立的进攻,起点可能在二三十秒之前:某次中场回收球,对手的阵型在那一刻被迫前压,此后的所有空档都从这里开始生长。要解释最后那一脚射门,模型必须把这条链子从头到尾看完,而不是只盯着最后五秒。
广播视频还带来额外的麻烦。镜头会在关键时刻切到特写,回放会打断连续的画面,主镜头常常追着球走,把远端的无球球员甩出画面。这意味着模型看到的“连续比赛”,其实是一个被剪辑过的、只有部分球员在场的片段序列。此外,长视频要在有限的输入长度里处理,通常会采取抽帧或先压缩成摘要再推理的做法,而抽帧可能恰好漏掉决定性的那一帧,摘要则可能丢失细节,等到最后做推理时,证据已经不在了。这也是为什么,长视频理解与短片段的事件识别是不同性质的挑战。
再看一个模拟场景。假设一段四十秒的模拟进攻:红队从后场断球开始,经过六脚传递,左边锋在边线附近内切后送出直塞,中锋推射得分。模型的解释是:“进攻成立是因为左边锋的内切吸引了防守。”但实际的关键其实早在第二十秒:红队右侧中场在一次看似无关的横向转移中,把对方的右边后卫拉到了中路,才让左边的空当有机会出现。若模型只看到最后十秒,它的解释听起来很合理,却指错了原因。这个错误无法从模型的输出里看出来,只有把关键帧的画面和球员位置摆出来对照,才能发现。
可验证性:一条战术解释怎样才算“说对了”
战术解释和事件识别的一个根本差别,在于后者有标准答案(这一脚球是不是射门),前者往往没有唯一答案。同一次进攻,两位教练可以有不同的理解,都不算错。这并不意味着战术推理无从检验。一种务实的做法是:不去追求“唯一正确的解释”,而是要求每条解释都能被检查。可检查至少包含下面几点:
- 解释要指向具体的时间戳,说明是哪几秒的画面支撑了这个结论。
- 解释要指向具体的球员和位置,例如某个追踪ID在某个时刻的坐标,而不是泛泛地说“防线被拉开”。
- 解释中的数值(距离、速度、空间大小)应该来自追踪和几何计算,而不是由语言模型凭感觉写出。
- 解释应当包含“如果不是这样会怎样”的检验,例如:如果拉边的球员没有移动,中路的空间是否仍然存在?
把解释拆成这样的“证据链”,最大的好处是把争论变得具体。教练可以说:“你说的这一步,我看第十二秒的位置不是这样。”这时争论已经从“模型说得对不对”变成了“这一帧的证据够不够”,后者才是可以被人和机器共同处理的问题。反过来,一个只给结论、不给证据的战术解释,即使措辞再专业,也应该被当作待核实的线索,而不是结论。
od体育的取舍:让视频模型提问题,让几何模块给数字
基于以上判断,od体育在足球战术分析里的设计思路,是把“理解”和“计算”分给不同的部件。视频与多模态模型适合做的事情,是在长视频里定位值得看的片段、提出候选的解释、把用户用自然语言提出的问题转成可以检查的查询;而所有需要精确数值的部分,例如球员间距、空间控制、传球线路是否被封,则交给追踪和几何计算模块。视频模型的输出,被当作“待验证的假设”,配上时间戳和球员编号,再由计算结果来印证或推翻。
阵型信息在这里担任骨架的角色。战术解释总是相对于某个阶段的阵型形状来说的:一名边后卫的前插,放在四后卫的形状里和放在三中卫的形状里,意义完全不同。因此,想知道比赛阶段和动态阵型如何被识别,可以参考《433真的一直是433吗?od体育AI如何识别比赛中的动态阵型变化》,它讲的是战术推理需要依赖的“形状与阶段”这层基础。
体育大模型能否真正读懂比赛,还要面对更宽的一组难题:时间跨度、坐标系对齐、标注稀缺、幻觉与可验证性。这些问题在《od体育官网如何理解“体育大模型”:真正困难的是让AI同时读懂动作、数据和比赛》里有更系统的梳理,本文讨论的战术推理,可以看作那些难题落在足球视频上的一个具体切面。
我们的判断:先做好“可复查”,再谈“会解释”
对比赛分析来说,解释得像不像专业解说,并不是最重要的;更重要的是这个解释错了的时候,有没有办法发现。一个总是流畅但偶尔编造依据的系统,比一个偶尔说“证据不足”的系统更危险,因为前者的错误藏在流畅的措辞里。因此od体育更倾向于让系统在证据不充分时明确说出“这里无法判断”,例如追踪数据缺失、关键球员被镜头切走、进攻的起点不在所分析的片段之内。
有几类情形,无论模型多强,最终的判断仍然应该由教练和分析师来做:战术意图的判断(这是布置好的套路,还是球员的临场选择)、涉及个别球员表现评价与起用的决策、模型解释与追踪数据互相矛盾的时候,以及任何会影响训练安排的结论。视频AI在战术分析里的位置,更接近一位勤勉的助理:帮你把几百个片段里值得一看的十来个挑出来,把每个片段的证据摆好,然后把判断权留给看过现场、了解球员的人。
从事件识别走向战术推理,这条路还很长,基准在变,方法也在变。可以确定的是,下一阶段的衡量标准不会只是“说得像不像”,而是“证据给得够不够”:只有当解释附上了证据,才有资格被称为推理。